Laboratorio
Mi laboratorio de IA local
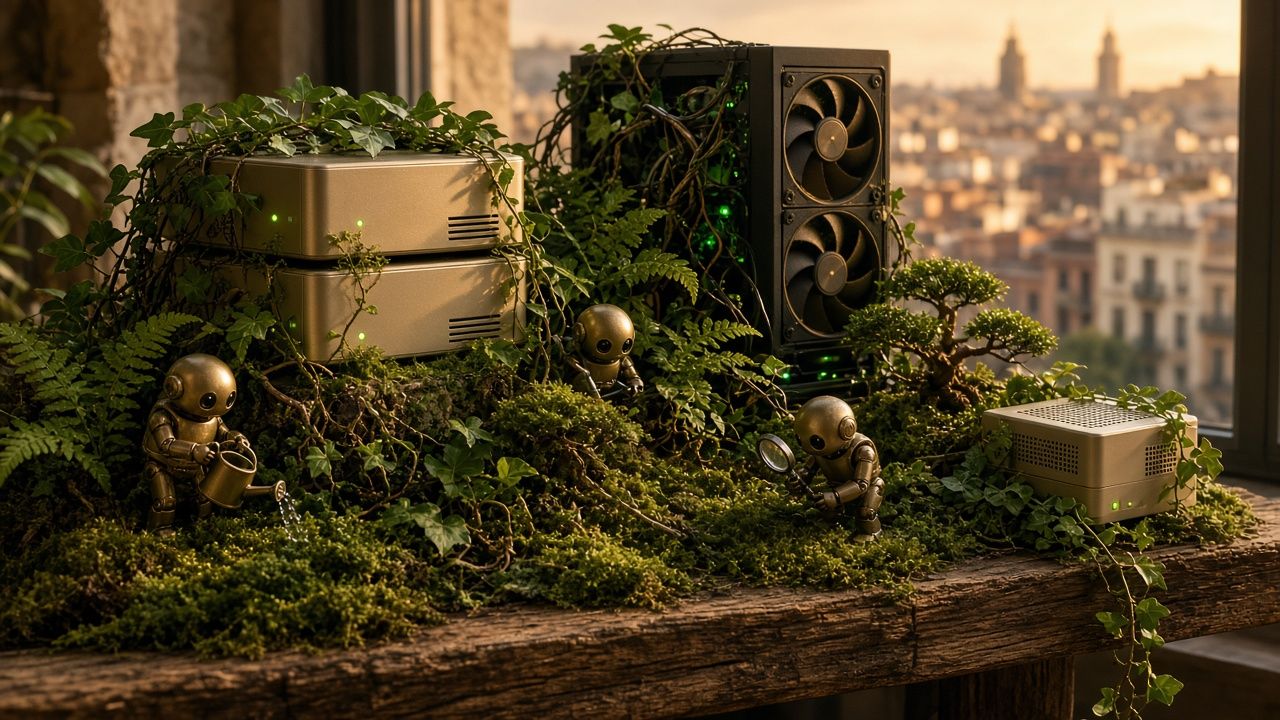
Dos superordenadores de escritorio, tres tarjetas gráficas, un mini PC y muchos agentes. Este es el sistema con el que trabajo cada día.
- de memoria unificada en el clúster
- 256 GB
- de VRAM en tres GPU RTX
- 56 GB
- entre los dos nodos
- 200 Gb/s
- tokens servidos (mayo–sept. 2026)
- ≈11.150 M
La idea
Quería comprobar algo sencillo: si una persona sola, en casa, puede tener una IA tan útil como las grandes plataformas sin enviarles ni un solo dato. La respuesta es que sí, siempre que se monte bien y se mantenga viva cuando los modelos cambian cada semana.
Lo que empezó como un experimento hoy sostiene mi trabajo diario, el de mi familia, el de algunos amigos y proyectos de clientes. Todo lo que ofrezco en file.cat lo he probado aquí antes.
El hardware
| Pieza | Qué es | Para qué la uso |
|---|---|---|
| 2 × NVIDIA DGX Spark (ASUS Ascent GX10) | Superchip GB10 con 128 GB de memoria unificada cada uno, unidos por ConnectX-7 a 200 Gb/s | Ejecutar en tándem (tensor parallel) el modelo grande de razonamiento, con hasta un millón de tokens de contexto |
| Servidor con 3 GPU | RTX 3090 de 24 GB y dos RTX 4060 Ti de 16 GB | Modelos de código, visión, embeddings, reranker, voz, transcripción e imagen |
| Mini PC con Proxmox | Ryzen y 16 GB, con tres contenedores LXC | El gateway de modelos, los agentes y los paneles, para que los nodos de inferencia solo infieran |
| Proxmox de la finca | Home Assistant, cámaras y el servidor de GPU virtualizado | La parte agrícola y doméstica |
| Red | Tailscale, TLS automático con Caddy y DNS dinámico | Acceso seguro desde cualquier sitio sin abrir puertos innecesarios |
Los modelos
No hablo de nombres concretos en la web comercial porque cambian cada pocas semanas, pero aquí sí:
| Rol | Modelo actual | Dónde corre |
|---|---|---|
Razonamiento general (spark) |
Qwen3.8-Flash-Next (~180B MoE, NVFP4), visión nativa, 512K de contexto | Clúster de dos Spark |
Código rápido (coder) |
Qwen3.8 27B con DFlash2, ~200 tok/s | RTX 3090 |
Código ligero (coder2) |
Qwen3.8 9B | RTX 4060 Ti |
Plagas agrícolas (agripests) |
Gemma 4 afinado para visión agrícola | RTX 4060 Ti |
| Embeddings y reranker | Qwen3-Embedding-4B y Qwen3-Reranker-4B | RTX 4060 Ti |
| Voz y transcripción | Qwen3-TTS con mi voz clonada y Whisper | RTX 4060 Ti |
| Imagen y vídeo | Qwen-Image 2.1 y modelos de ComfyUI | RTX 3090 |
Por el clúster han pasado también DeepSeek V4 Flash con un millón de tokens de contexto, GLM-5.3-Flash de 320.000 millones de parámetros y Qwen3.5-122B. Cambiar de modelo grande sin cortar el servicio es parte del oficio: hice tres cambios en cinco días en agosto mientras los agentes seguían trabajando.
El gateway: mi «OpenAI» privada
Todo pasa por un gateway LiteLLM con ocho roles estables. Los clientes piden spark o coder, no un modelo concreto, así que puedo cambiar lo que hay detrás sin que nadie toque su configuración.
- Cuentas por persona y por agente, equipos y presupuestos.
- Endpoint compatible con OpenAI, publicado con TLS en
openai.file.cat. - Control del modo de razonamiento de cada modelo en el propio alias.
- Panel de consumo propio que reparte los tokens por persona y por modelo.
Entre mayo y octubre de 2026 sirvió unos 11.150 millones de tokens. Un solo usuario, con su propio agente, acumula más de 6.000 millones.
Árbitros de GPU
Una RTX 3090 no puede tener a la vez un modelo de código de 27B y la generación de imágenes. En lugar de elegir, escribí dos árbitros de GPU que hacen turnos automáticos: si llega una petición para el modelo que está apagado, el árbitro lo levanta, espera a que esté listo y responde. Si la tarjeta está ocupada con un render, contesta con un mensaje claro y el tiempo estimado.
Lo que corre encima
- Nueve perfiles de agente en un único gateway de Discord, con memoria vectorial propia por perfil. Están explicados en Agentes.
- Instancias aisladas para la finca familiar, para mis hermanas y para el equipo de Nuzic.
- Voz: transcripción de reuniones con quién habla y respuestas habladas con mi voz.
- Imagen: generación local con Qwen-Image desde los propios agentes.
- Búsqueda y documentos: SearXNG, Firecrawl y extracción de PDF, todo autoalojado.
- Paneles y alertas: un panel de estado y consumo construido por los agentes y un vigilante que avisa en Discord si algo cae.
Cifras que he medido
| Prueba | Resultado |
|---|---|
| Qwen3.8-Flash-Next, 8 conversaciones a la vez | ~325 tok/s agregados |
| Mismo modelo, 1 conversación | 57 tok/s en prosa y 72 tok/s en código |
| Modelo de código 27B en una RTX 3090 | ~200–222 tok/s |
| Copia de 135 GB de pesos entre nodos | ~3 minutos |
| Fallback con el modelo local caído | 0,6 s |
Lo que he aprendido
- La memoria manda. En la memoria unificada, cada punto de reserva cuenta, y el contexto largo no sale gratis.
- Los nodos de inferencia solo deben inferir. Sacar gateway y agentes a un mini PC estabilizó todo.
- Nunca un fallback oculto. Si el modelo local falla, se nota; nadie cambia de modelo sin saberlo.
- Roles estables, modelos intercambiables. El cliente pide un rol; lo que hay detrás puede mejorar cada semana.
- Medirlo todo. Velocidad, memoria, consumo y quién usa qué. Sin cifras no hay decisiones.
¿Quieres uno así?
Monto versiones a medida para empresas, desde un puesto con una sola GPU hasta un clúster como este. Lo explico en file.cat, con precios orientativos.